jeudi 19 janvier 2012

Rapports dans libreoffice base

Nous allons montrer, sur un exemple, comment dans libreoffice base réaliser un rapport contenant des sous-totaux et un grand total. Pour ce faire nous aurons besoin de l'extension "Oracle Report Builder". De nombreuses distributions fournissent un paquet qui installe cette extension, paquet le plus souvent appelé libreoffice-report-builder. A défaut de paquet, on peut également trouver cette extension ici. Notre rapport sera basé sur les données de la table PostgreSQL "opération" appartenant à bdtest, notre base de données de test, et qui a été introduite dans ce billet.
Pour faciliter notre travail, crééons une vue avec cette instruction exécutée dans un terminal psql connecté à bdtest:
CREATE VIEW opérationv2
AS
SELECT jour, seq, 
CASE  
 WHEN montant > 0 THEN
 montant 
ELSE 0
END AS crédit,
CASE  
 WHEN montant < 0 THEN
 -montant 
ELSE 0
END AS débit,
montant AS solde
FROM opération
Après avoir connecté libreoffice à bdtest, cliquons sur "Créer un rapport en mode Ébauche".
La première étape consiste à choisir la source des données, à savoir la vue opérationv2 (qui est considérée comme une table par libreoffice):


Par défaut, le rapport contient 3 sections dont seule la section "Détail" est prévue pour accueillir des données. Il est clair que nous aurons besoin de davantage de sections (pour les sous-totaux notamment). Heureusement celles-ci vont se créer automatiquement dans la suite.
Cliquons sur l'icône "Tri et groupement" de la barre d'outils standard:


et choisissons de grouper nos données par jour:


Nous n'oublions pas de sélectionner "Présent" pour "Grouper le pied de page" afin de disposer d'une section pour les sous-totaux.
Demandons également que tout le groupe soit conservé ensemble.
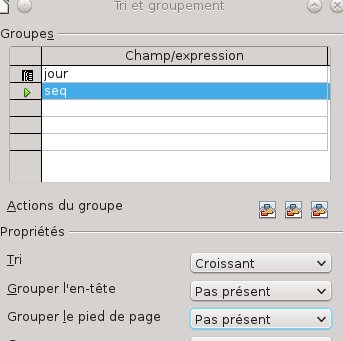
Enfin, ajoutons seq comme groupe afin de pouvoir définir un tri, mais nous ne voulons pas cette fois de section supplémentaire (il ne s'agit pas vraiment d'un groupe):

Nous pouvons commencer à disposer les différents champs et étiquettes sur le rapport. Procédons en premier, comme montré sur l'image ci-dessous, avec le champ "jour" qui se placera, précédé de son étiquette, dans la section "jour En-tête" préalablement sélectionnée:


Pour les données de la zone détail nous allons procéder autrement car nous ne voulons pas placer les étiquettes dans cette zone, mais bien dans la zone en-tête de groupe.
Sélectionnons "zone de texte" dans la barre d'outils "Contrôles de rapport" et déployons le champ à l'endroit qui convient:


La donnée à placer dans ce champ peut être choisie dans le panneau latéral droit des propriétés, onglet données:


Nous avons placé le champ de données seq. Procédons de même avec les champs débit, crédit et solde.
Tous les champs de la zone détail étant sélectionnés, nous fixons via l'onglet "Général" du panneau des propriétés les alignements et le formatage:


(il faudra plus tard mettre un formatage sans décimales pour seq)

Ensuite, nous cliquons sur les icônes "Aligner en haut de la section":


et "Réduire à partir du bas":


Cliquant sur l'icône "Champ d'étiquette"


déployons en dessous du champ seq,  et donc forcément dans la section "jour Pied de page", une étiquette avec la mention "total jour". De même plaçons en dessous des champs débit, crédit et solde, des zones de texte. Mais cette fois, au niveau des propriétés, "Type de champs de données", nous choisissons "Fonction", ensuite le Champ de données et comme fonction "Accumulation" :


Sélectionnant ensemble les trois champs de données, fixons comme auparavant les alignements (horizontal à droite, vertical au milieu) ainsi que le formatage (numérique avec décimales et séparateur de milliers). Ensuite nous alignons l'ensemble des champs en haut de la section et puis nous réduisons celle-ci.
Très bien. Mais où placer la ligne "Grand total" ? Nous avons besoin d'une section supplémentaire. Il nous faudrait un pied de page pour l'ensemble du rapport. Nous pouvons l'obtenir via le menu "Edition":


Reproduisons dans ce nouveau pied de page ce qui se trouve dans le pied de page de groupe, mis à part que l'étiquette contiendra la mention "TOTAL" et que pour les 3 champs de données la fonction accumulation sera étendue à l'ensemble du rapport:


Disposons maintenant dans la section en-tête du groupe jour, les étiquettes correspondant aux données figurant dans la section détails. Laissons un espace entre ces étiquettes et la limite inférieure de la section afin de pouvoir souligner l'ensemble. Au besoin, nous pouvons les aligner via l'icône "En haut" de la barre d'outils "Aligner":


Pour souligner l'ensemble de ces étiquettes, on s'attend à pouvoir utiliser l'icône "Ligne horizontale" de la barre d'outils "Contrôles de rapport":


Malheureusement les lignes obtenues en utilisant cet outil sont invisibles lorsque le rapport est exécuté.
Comment procéder? Utiliser la forme rectangle?


Toute tentative de redimensionner l'objet (pour le faire ressembler à une ligne) entraîne un plantage immédiat.
La solution consiste à placer un champ d'étiquette, sans libellé, avec une couleur d'arrière blanc et dont on contrôle la hauteur via le panneau propriété:


Nous soulignons également (en rouge cette fois) le champ "jour" précédé de son étiquette.
Dans la section "En-tête de rapport", déployons une étiquette contenant le titre du rapport (sur fond jaune pâle).
Dans la section "En-tête", plaçons via le menu insertion date et numéros de page.
Le résultat aura plus belle allure si nous adaptons la couleur du texte qui surmonte un trait à la couleur de ce trait:


Pour améliorer la présentation, donnons également une couleur de fond à l'ensemble formé par le champ jour et son libellé: nous choisissons "gris bleu".
D'autre part, il est préférable de garder l'ensemble de l'en-tête de groupe sur une même page:


(Ceci est inutile si auparavant il a été demandé de conserver ensemble tout le groupe.)

En ce qui concerne la section "Pied de groupe", nous lui attribuons la couleur d'arrière plan "gris clair".
Il reste à séparer le total général du reste du rapport par un trait.
Et voici le résultat:


EDIT: voir deux autres exemples de rapport dans ce billet


mardi 27 décembre 2011

Tubes dans psql (suite)

Considérons une requête sql, contenue dans un fichier et dont le résultat est envoyé par un tube vers la commande awk.
Le script à utiliser par awk dépend de la configuration.
Ainsi, si un titre a été défini par une méta-commande, la première ligne avec des données sera la ligne # 4 (au lieu de # 3).
Si de plus le style de bordure est de type 2, ce sera la ligne # 5.
C'est pourquoi il peut être utile de placer dans un fichier contenant une instruction de redirection vers un tube, les méta-commandes de configuration comme par exemple:
\pset title Rapport
Pour éviter de polluer l'output par des messages tels que:
Le titre est « Rapport »
il convient alors de définir en premier la variable d'environnement QUIET.
D'autre part, on voudrait aussi après exécution de la requêtre rétablir la configuration par défaut, de sorte qu'un tel fichier pourrait ressembler à ceci:
\set QUIET
\pset numericlocale on
\pset footer off
\pset linestyle u
\pset title 'Rapport'
\pset border 2
\o | awk -f titre-border-2.awk | tee Rapport.txt
--++++++++++++++++++++++++++++++++++++++++++++++
--            Début de la requête
--++++++++++++++++++++++++++++++++++++++++++++++
SELECT ....
......
;
--++++++++++++++++++++++++++++++++++++++++++++++
--            Fin de la requête
--++++++++++++++++++++++++++++++++++++++++++++++
\o
\pset footer
\pset title
\pset border 1
\unset QUIET
(Notons l'utilisation, comme il se doit en sql, de -- pour commenter une ligne)

Ci dessus un script awk adapté à la présence d'un titre et à un style de bordure de niveau 2, servant à la mise en forme du titre et à l'impression d'une ligne de séparation avant une ligne "TOTAL" éventuelle:
# Sauvegarde du titre dans t et u
NR == 1 {
  t=$0 
  u=t
}
# Récupération du caractère pour tracer les lignes
# Impression du titre
NR == 2 {
  a=substr($0,2,1)
  gsub(/[^[:space:]]/,a,u)
  while (gsub(/[^[:space:]] /,a a,u)) {
  }
  print "\n" u "\n" t "\n" u "\n"
}
# Sauvegarde ligne de séparation dans y
NR == 4 {
  y=$0
}
/^..TOTAL/ {
   print y 
}
# Ne plus imprimer le titre (ligne # 1)
NR > 1
Le titre contenu dans $0 puis sauvegardé dans t est précédé du nombre d'espaces qui convient pour qu'il soit centré.
La ligne u, au départ une copie de t, qui sera imprimée juste avant et juste après le titre, est modifiée dans un premier temps en remplaçant par a de tout ce qui n'appartient pas à la classe prédéfinie [:space:], et ensuite en remplaçant aussi (par a) les espaces qui sont au milieu de la chaîne des a (les espaces qui étaient contenus dans le titre).

Notes:
  • La lecture du billet "Expressions régulières" pourrait être utile en cas de difficulté de compréhension d'une notation telle que [^[:space:]]
  • Il arrive que la classe [:space:] ne soit pas reconnue par le programme awk qui est appelé (c'est le cas chez Ubuntu où /etc/alternatives/awk pointe vers /usr/bin/mawk). Il convient alors d'installer gawk.
  • Dans ce script (et dans les suivants) on pourrait remplacer [^[:space:]] par la notation abrégée \S (pas chez Ubuntu, même avec gawk installé).
  • La classe [:space:] comprend outre les espaces, les caractères de contrôle tabulation (\t), tabulation verticale (\v), saut de page (\f), retour chariot (\r), nouvelle ligne (\n). Mais à l'intérieur du script, awk travaille sur des lignes qui ont été débarrassées de leur \n final. Celui-ci est remis par l'action "print".
  • gsub retourne 1 en cas de substitution effectuée: il devient alors une condition vérifiée pour la commande while (qui est utile lorsque le titre comprend plusieurs espaces successifs).
  • a a représente la concaténation de a et de a.
Comme le caractère servant à tracer les lignes horizontales est récupéré à partir de l'input, le script peut servir quel que soit le style de ligne.
On obtient dans le cas d'un style de ligne unicode:


Le script peut être utilisé même en l’absence de ligne "TOTAL": il sert alors simplement à mettre en forme le titre.
Si le style de bordure est de niveau 1, il faut attendre la ligne 3 pour récupérer le caractère servant à tracer les lignes.
Le script (qui pourrait s'appeler titre-border-1.awk) se présente alors comme ceci:
# Sauvegarde du titre dans t et u
NR == 1 {
  t=$0 
  u=t
}
# Sauvegarde des en-têtes dans h
NR == 2 {
  h=$0
}
# Sauvegarde de la ligne de séparation dans y
# Récupération du caractère pour tracer les lignes
# Impression du titre puis des en-têtes
NR == 3 {
  y=$0
  a=substr($0,2,1)
  gsub(/[^[:space:]]/,a,u)
  while (gsub(/[^[:space:]] /,a a,u)) {
  }
  print "\n" u "\n" t "\n" u "\n"
  print h
}
/^.TOTAL/ {
   print y 
}
# Ne plus imprimer le titre et les en-têtes
NR > 2

Envisageons maintenant d'envoyer le résultat d'une requête vers un tube afin d'en numéroter les lignes avec cette méta-commande:

\o | awk '{printf("%5d\t%s\n", NR, $0)}'

Nous utilisons printf afin que les numéros des lignes soient justifiés à droite: on imprime d'abord NR en tant que nombre décimal précédé d'espaces jusqu'à atteindre la longueur 5 (%5d), un caractère de tabulation (\t), ensuite la ligne reçue en input en tant que chaîne de caractères (%s).
Notons que printf (contrairement à print) ne met pas de caractère nouvelle ligne (\n) à la fin de son envoi. Il doit donc être explicitement ajouté.
En présence d'un titre et avec un style de bordure de niveau 1, on obtient:


Bien sûr, on voudrait seulement numéroter les lignes de données et en plus mettre en forme le titre et séparer la ligne "TOTAL" éventuelle du reste.
Pour ce faire, il suffit par exemple, d'adapter le script précédent (qui convient pour un style de bordure de niveau 1):

# Sauvegarde du titre dans t et u
NR == 1 {
  t= "\t" $0 
  u=t
}
# Sauvegarde des en-têtes
NR == 2 {
  h= "\t" $0
}
# Sauvegarde de la ligne de séparation dans y
# Impression du titre, des en-têtes et de la ligne de séparation qui suit
NR == 3 {
  y= "\t" $0
  a=substr($0,2,1)
  gsub(/[^[:space:]]/,a,u)
  while (gsub(/[^[:space:]] /,a a,u)) {
  }
  print "\n" u "\n" t "\n" u "\n"  
  print h
  print y 
}
/^.TOTAL/ {
  print y 
  print "\t" $0
}
# Numéroter puis imprimer les données
# Ne pas procéder pour la ligne TOTAL éventuelle, ni pour les lignes vides
NR > 3 && !/^.TOTAL/ && !/^$/ {
  n++
  printf("%5d\t%s\n", n, $0)
}
# Impression des lignes vides
/^$/
(u comprend maintenant un caractère de tabulation, mais comme ce caractère fait partie de la classe [:space:], cela ne change rien en ce qui concerne le résultat de gsub)

L'utilisation du script ci-dessus nous donne:


Adapter pour la numérotation le script convenant pour le style de bordure de niveau 2 est un peu plus ardu.
Le problème est d'éviter la numérotation de la dernière ligne non vide (qui fait partie du cadre):
# Sauvegarde du titre dans t et u
NR == 1 {
  t= "\t" $0 
  u=t
}
# Impression du titre et de la partie supérieure du cadre
NR == 2 {
  a=substr($0,2,1)
  gsub(/[^[:space:]]/,a,u)
  while (gsub(/[^[:space:]] /,a a,u)) {
  }
  print "\n" u "\n" t "\n" u "\n"
  print "\t" $0
}
# Impression des en-têtes
NR == 3 {
  print "\t" $0
}
# Sauvegarde dans y et impression de la ligne de séparation
NR == 4 {
  y= "\t" $0
  print y
}
/^..TOTAL/ {
  print y 
  print "\t" $0
}
# Impression de la partie inférieure du cadre
NR > 4 && substr($0,2,1)==a {
  print "\t" $0
}
# Numéroter puis imprimer les données
# Ne pas procéder pour la ligne TOTAL éventuelle, ni pour les lignes vides
# ni pour les lignes de cadre
NR > 4 && !/^..TOTAL/ && !/^$/ && substr($0,2,1)!=a {
  n++
  printf("%5d\t%s\n", n, $0)
}
# Impression ligne vide
/^$/

Et voici le résultat:


Les scripts awk présentés ici dépendent certes du style de bordure et de la présence d'un titre, mais ils sont indépendants du style de ligne.
Par exemple avec un autre style de ligne, une autre table et un autre titre, l'utilisation du même script donne ceci:


mercredi 21 décembre 2011

Tubes dans psql

Un terminal psql est un terminal connecté à une base de données PostgreSQL qui permet d'exécuter des instructions sql.
On peut aussi y introduire des méta-commandes: commandes précédées d'une barre oblique inversée (backslash). Certaines méta-commandes ont déjà été présentées dans ce blog telle
\o [FICHIER]
qui envoie le résultat des requêtes ultérieures dans le fichier FICHIER.
Mais cette méta-commande permet également d'envoyer les résultats des requêtes dans un tube (pipe). Dans ce billet, nous allons montrer comment tirer parti de cette dernière possibilité.
Connectons nous à notre base de données de test et retrouvons grâce à la méta-commande \dS les caractéristiques de la table opération:


Nous avons aussi créé une vue opérationv avec l'instruction

CREATE VIEW opérationv 
AS
SELECT jour, seq,  
CASE
 WHEN montant > 0 THEN  montant  
 ELSE 0 
END AS crédit, 
CASE
 WHEN montant < 0 THEN  -montant  
 ELSE 0 
END AS débit, 
contrepartie 
FROM opération ;

Avec cette vue, la dernière requête du billet précédent, qui paraissait monstrueuse, prend tout de suite un visage plus sympathique:

SELECT jour, sum(crédit) AS crédit,
sum(débit) AS débit, 
sum(crédit) - sum(débit) AS solde
FROM
opérationv
GROUP BY jour
UNION
SELECT 'TOTAL' AS jour, sum(crédit) AS crédit,
sum(débit) AS débit, 
sum(crédit) - sum(débit) AS solde
FROM
opérationv
ORDER BY jour
;

Nous avons placé cette requête dans le fichier bilan.sql.
Exécutons la:


Nous retrouvons bien le même résultat que précédemment.
Avant de procéder avec bilan.sql, nous avons exécuté deux méta-commandes. La méta-commande "\pset numericlocale" a déjà été commentée précédemment.
Quant à la méta-commande "\pset footer off", il suffit de jeter un coup d'oeil distrait sur le résultat situé à la fin du billet précédent pour saisir quel est son objet.

On voudrait améliorer le résultat affiché et obtenir par exemple quelque chose comme:

   jour   |  crédit  | débit  | solde  
----------+----------+--------+--------
 2011-255 | 1.460,45 | 673,29 | 787,16
 2011-256 |    57,49 |  48,00 |   9,49
 2011-257 |        0 |  28,27 | -28,27
=======================================
 TOTAL    | 1.517,94 | 749,56 | 768,38

Pour arriver à nos fins, nous allons à l'aide d'un tube envoyer le résultat vers la commande:

awk '/^ TOTAL/ {while (a++<=length($0)) x=x "="; print x }; 1'

Un billet entier est consacré dans ce blog à awk.

Le script de la commande awk (ce qui est compris entre les deux apostrophes) comprend ici deux instructions (séparées par le point-virgule qui est devant le 1).
Rappelons qu'une instruction awk est constituée d'une condition suivie de une où plusieurs actions qui s'exécutent seulement si la condition est vérifiée.
awk va lire une à une les différentes lignes du résultat et effectuer (éventuellement) les actions comprises dans les instructions.
Analysons la première instruction:

/^ TOTAL/ {while (a++<=length($0)) x=x "="; print x }

Elle comprend une condition suivie de deux actions placées entre crochets et séparées par un point-virgule.
En rouge la condition: avoir le mot "TOTAL" en deuxième position.
En bleu l'action 1: construire avec "=" une chaîne de longueur égale à la longueur de la ligne lue (qui se trouve dans la variable $0).
En vert l'action 2: imprimer (envoyer vers la sortie standard) la chaîne qui vient d'être construite.  
La deuxième instruction est très simple: elle comprend simplement la condition "1" qui est toujours vérifiée et réalise donc à chaque fois l'action par défaut "print".
Cette deuxième instruction sert simplement à imprimer (envoyer vers la sortie standard) tout ce qui a été lu.
Ajoutons en tête du fichier bilan.sql, la méta-commande:
\o | awk '/^ TOTAL/ {while (a++<=length($0)) x=x "="; print x }; 1'
ce qui aura pour effet d'envoyer via le tube " | " l'output de la requête sql vers awk.
Et pour remettre les chose en état après exécution du query, terminons le fichier avec
\o
Et voilà:


Il y a plus simple.
Par exemple envoyer la sortie vers
awk 'NR==2 {y=$0};/^ TOTAL/ {print y};1'

Cette fois le script awk comprend trois instructions.
Instruction 1: si la ligne lue est la ligne 2, la sauvegarder dans y
Instruction 2: si la ligne lue contient "TOTAL" en position 2, imprimer y
Instruction 3: imprimer de manière inconditionnelle la ligne lue.
Et voici le résultat obtenu:


Il est possible d'améliorer encore le résultat (pour par exemple afficher un titre), mais cela va compliquer (un tout petit peu) le script awk. Pour plus de clarté, plaçons le script modifié dans un fichier que nous appelons bilan.awk (les conditions sont en rouge):

NR == 1 {
  while (a++<=length($0)/2-5) x=x " "
  print "\n" x "Bilan" "\n" x "+++++" "\n"
}
NR == 2 {
  y=gensub(/-/,"=","G")
}
/^ TOTAL/ {
   print y 
}
1

Instruction 1: elle comprend deux actions conditionnées par NR == 1, donc qui s'exécutent seulement à la lecture de la première ligne.
Action 1: construction d'une chaîne d'espaces dans le but de centrer le mot "Bilan"
Action 2: impression du titre ("\n" est le caractère de contrôle nouvelle ligne)
Instruction 2: on sauvegarde dans y la ligne lue (ligne 2) dans laquelle on a remplacé tous les "-" par des "=".
Les deux instructions restantes sont inchangées.

Plaçons en tête du fichier bilan.sql la méta-commande:

\o | awk -f bilan.awk

Testons le résultat:


Si nous voulons envoyer le résultat obtenu vers un fichier bilan.txt tout en gardant l'affichage à l'écran, il suffit d'utiliser un deuxième tube:
\o | awk -f bilan.awk | tee bilan.txt
Il nous est bien sûr loisible de ne rien envoyer vers l'écran:
\o | awk -f bilan.awk > bilan.txt

dimanche 18 décembre 2011

Jointures et autres requêtes sql

Dans notre base de données PostgreSQL de test, nous créons deux tables à l'aide des instructions SQL suivantes:
CREATE TABLE opération
(jour CHAR(8),
 seq SMALLINT,
 montant NUMERIC(13,2),
 contrepartie CHAR(5),
 PRIMARY KEY (jour, seq))
;
CREATE TABLE contrepartie
(contrepartie CHAR(5) PRIMARY KEY,
 libellé VARCHAR(50))
;
et nous y plaçons quelques données, données que nous pouvons facilement retrouver grâce à des requêtes SQL élémentaires, exécutées par exemple dans un terminal psql:


Nous aimerions maintenant faire apparaître à la suite de chaque opération le libellé de la contrepartie. Pour ce faire nous devons réaliser une jointure entre les deux tables. Diverses possibilités s'offrent à nous.
Jointure intérieure (INNER JOIN):
bdtest=> SELECT a.jour, a.seq, a.montant, b.libellé
bdtest-> FROM opération a INNER JOIN contrepartie b
bdtest-> ON a.contrepartie = b.contrepartie
bdtest-> ORDER BY a.jour, a.seq
bdtest-> ;
   jour   | seq | montant |    libellé     
----------+-----+---------+----------------
 2011-255 |   2 | -400.00 | Epargne #1
 2011-255 |   3 | -123.29 | Grande Surface
 2011-255 |   4 | -150.00 | Alphonse
 2011-256 |   2 |   57.49 | Epargne #2
(4 lignes)
Le mot INNER est facultatif car il s'agit du type de jointure par défaut.
Les deux colonnes qui sont jointes portent le même nom. Dans ce cas, nous aurions pu arriver au même résultat avec le query suivant:
SELECT a.jour, a.seq, a.montant, b.libellé
FROM opération a NATURAL JOIN contrepartie b
ORDER BY a.jour
;
Un problème se pose: toutes les opérations ne sont pas reprises.
Nous devons donc utiliser un autre type de jointure:
Jointure extérieure gauche (LEFT OUTER JOIN):
bdtest=> SELECT a.jour, a.seq, a.montant, b.libellé
bdtest-> FROM opération a NATURAL LEFT OUTER JOIN contrepartie b
bdtest-> ORDER BY a.jour, a.seq
bdtest-> ;
   jour   | seq | montant |    libellé     
----------+-----+---------+----------------
 2011-255 |   1 | 1460.45 | 
 2011-255 |   2 | -400.00 | Epargne #1
 2011-255 |   3 | -123.29 | Grande Surface
 2011-255 |   4 | -150.00 | Alphonse
 2011-256 |   1 |  -48.00 | 
 2011-256 |   2 |   57.49 | Epargne #2
 2011-257 |   1 |  -28.27 | 
(7 lignes)
Lorsque la colonne a.contrepartie contient une valeur qui n'existe pas dans la table contrepartie, le système joint à la rangée concernée de la table opération une rangée (fictive) de la table contrepartie dont tous les champs sont à la valeur NULL. En ajoutant une clause WHERE au query précédent (et en modifiant aussi la clause SELECT), nous pouvons établir une liste des contreparties dont le libellé manque:
bdtest=> SELECT DISTINCT a.contrepartie
bdtest-> FROM opération a NATURAL LEFT OUTER JOIN contrepartie b
bdtest-> WHERE b.contrepartie IS NULL
bdtest-> order by a.contrepartie
bdtest-> ;
 contrepartie 
--------------
 autre
 EL   
 RN   
(3 lignes)
D'autres queries conduisent au même résultat:
SELECT DISTINCT a.contrepartie
FROM opération a
WHERE NOT EXISTS
(SELECT *
 FROM contrepartie b
 WHERE b.contrepartie = a.contrepartie)
ORDER by a.contrepartie
;
ou encore:
SELECT DISTINCT contrepartie
FROM opération 
WHERE contrepartie NOT IN
(SELECT contrepartie
 FROM contrepartie )
ORDER by contrepartie
;
Nous n'avons pas épuisé toutes les possibilités en ce qui concerne les types de jointures:
Jointure externe droite (RIGHT OUTER JOIN)
bdtest=> SELECT a.jour, a.seq, a.montant, b.libellé
bdtest-> FROM opération a NATURAL RIGHT OUTER JOIN contrepartie b
bdtest-> ORDER BY a.jour
bdtest-> ;
   jour   | seq | montant |    libellé     
----------+-----+---------+----------------
 2011-255 |   2 | -400.00 | Epargne #1
 2011-255 |   3 | -123.29 | Grande Surface
 2011-255 |   4 | -150.00 | Alphonse
 2011-256 |   2 |   57.49 | Epargne #2
          |     |         | Magasin
(5 lignes)
Cette fois tous les libellés de la table de droite font partie du résultat, qu'il y ait ou non des opérations correspondantes.
Et enfin...
Jointure  complète (FULL JOIN)
bdtest=> SELECT a.jour, a.seq, a.montant, b.libellé
bdtest-> FROM opération a  NATURAL FULL JOIN contrepartie b
bdtest-> ORDER BY a.jour
bdtest-> ;
   jour   | seq | montant |    libellé     
----------+-----+---------+----------------
 2011-255 |   1 | 1460.45 | 
 2011-255 |   2 | -400.00 | Epargne #1
 2011-255 |   3 | -123.29 | Grande Surface
 2011-255 |   4 | -150.00 | Alphonse
 2011-256 |   1 |  -48.00 | 
 2011-256 |   2 |   57.49 | Epargne #2
 2011-257 |   1 |  -28.27 | 
          |     |         | Magasin
(8 lignes)
Répartition sur deux colonnes des crédits et des débits
Dans la table opération tous les montants sont dans une seule colonne. Il est possible de les afficher sur deux colonnes, une réservée aux crédits et une autre pour les débits:
bdtest=> SELECT jour, seq, libellé,
bdtest-> CASE  
bdtest->  WHEN montant > 0 THEN
bdtest->  montant 
bdtest-> ELSE 0
bdtest-> END AS credit,
bdtest-> CASE  
bdtest->  WHEN montant < 0 THEN
bdtest->  -montant 
bdtest-> ELSE 0
bdtest-> END AS debit
bdtest-> FROM opération NATURAL LEFT OUTER JOIN contrepartie
bdtest-> ORDER BY jour;
   jour   | seq |    libellé     | credit  | debit  
----------+-----+----------------+---------+--------
 2011-255 |   1 |                | 1460.45 |      0
 2011-255 |   2 | Epargne #1     |       0 | 400.00
 2011-255 |   3 | Grande Surface |       0 | 123.29
 2011-255 |   4 | Alphonse       |       0 | 150.00
 2011-256 |   1 |                |       0 |  48.00
 2011-256 |   2 | Epargne #2     |   57.49 |      0
 2011-257 |   1 |                |       0 |  28.27
(7 lignes)

bdtest=> \w opération.sql
Après exécution de la requête, nous avons écrit celle-ci dans le fichier opération.sql en vue d'un usage ultérieur.
Exportation vers un tableur
L'output de la requête ci-dessus peut-être redirigé vers un fichier et formaté de manière telle que les données puissent être facilement exportées vers un tableur. Pour ce faire, il suffit d'utiliser dans notre terminal psql les meta commandes suivantes:
\pset numericlocale (pour avoir par exemple 1.460,45 au lieu de 1460.45)
\a pour passer au mode de sortie non aligné
\t pour afficher uniquement les rangées (sans les en-têtes)
\f ';' pour initialiser le séparateur de champ à ';'
\o [FICHIER] pour envoyer le résultat de la requête vers le fichier FICHIER
\i  [FICHIER] pour exécuter les commande du fichier FICHIER (ce n'est évidemment pas le même)
bdtest=> \pset numericlocale
Affichage de la sortie numérique adaptée à la locale.
bdtest=> \a
Le format de sortie est unaligned.
bdtest=> \t
Affichage des tuples seuls.
bdtest=> \f ';'
Le séparateur de champs est « ; ».
bdtest=> \o bilan.csv
bdtest=> \i opération.sql
bdtest=> 
Ouvrons bilan.csv dans un tableur.
Rapidement nous arrivons à ceci:


Bilans comme résultat de requêtes
L'idéal pour obtenir un bilan est d'utiliser un tableur. Il est également possible d'établir un rapport depuis un outil comme libreoffice base.
Cependant de simples requêtes permettent d'arriver à de bons résultats.
Ainsi:
SELECT jour, seq, libellé,
CASE  
 WHEN montant > 0 THEN
 montant 
 ELSE 0
END AS credit,
CASE  
 WHEN montant < 0 THEN
 -montant 
 ELSE 0
END AS debit,
montant AS solde
FROM opération NATURAL LEFT OUTER JOIN contrepartie
UNION
SELECT 'Total' AS jour, 0 AS seq, '' AS libellé,
sum(credit) AS credit,
sum(debit) AS debit,
sum(solde) AS solde
FROM (SELECT
CASE  
 WHEN montant > 0 THEN
 montant 
 ELSE 0
END AS credit,
CASE  
 WHEN montant < 0 THEN
 -montant 
 ELSE 0
END AS debit,
montant AS solde
FROM opération NATURAL LEFT OUTER JOIN contrepartie
) a
ORDER BY jour, seq
;
nous donne (on a laissé numericlocale activé):


Ce query:
SELECT 
jour, 
sum(credit) AS credit,
sum(debit) AS debit,
sum(solde) as solde
FROM (SELECT jour,
CASE  
 WHEN montant > 0 THEN
 montant 
END AS credit,
CASE  
 WHEN montant < 0 THEN
 -montant 
END AS debit,
montant AS solde
FROM opération) a
GROUP BY jour
UNION
SELECT 
'Total' AS jour,
sum(credit) AS credit,
sum(debit) AS debit,
sum(solde) AS solde
FROM (SELECT
CASE  
 WHEN montant > 0 THEN
 montant 
END AS credit,
CASE  
 WHEN montant < 0 THEN
 -montant 
END AS debit,
montant AS solde
FROM opération) a
ORDER BY jour
;
conduit au résultat: